

목차
1. 다양한 형식의 데이터 읽기
1) 공백 문자로 구분된 데이터 읽기(list input)
•
모든 자료 값이 하나 이상의 공백문자로 구분되어 있는 경우에 사용
•
INPUT 명령문에 변수명을 순서대로 입력해야 함
•
문자형 변수의 경우 변수명 뒤에 $로 표기
•
결측값은 한 개의 마침표(.)로 표시되어야 함
•
문자 변수의 자료 값은 공백문자를 포함하지 않아야 하며, 길이가 8자리를 넘지 않아야 함
•
한 행에 여러 관찰치의 자료가 연속하여 입력된 경우에는 @@(double trailing at)을 사용
◦
@@ : 해당 줄에 있는 모든 자료의 값을 전부 읽을 때까지 다음 줄로 포인터가 이동하지 않도록 지정
•
예시 1
DATA grade;
INPUT id name $ class $ score grade $;
CARDS;
2590 john Stat 80.3 A
3569 willy Math . B
7048 younghee . 30.6 C
9087 . Eng 100 A
;
RUN;
Plain Text
복사
•
예시 2
DATA one;
INPUT x y @@;
CARDS;
1 2 3 4
5 6 7
8 9 10
;
RUN;
Plain Text
복사
2) 고정 문자로 구분된 데이터 읽기(column input)
•
모든 자료 값들이 열에 맞추어 정리되어 있는 경우에 사용한다.
•
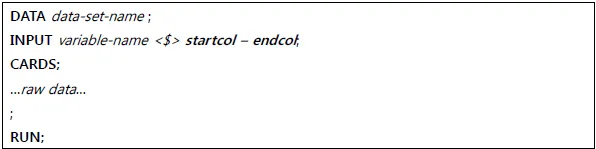
INPUT 명령문에 각 변수 명 뒤 해당 변수 자료 값이 들어있는 열 지시자를 입력
•
‘공백 문자로 구분된 데이터 읽기(list input)’에 비해 다음과 같은 이점이 있음
◦
자료 값들 사이에 공백문자를 입력하지 않아도 됨
◦
문자 변수의 자료가 공백문자를 포함할 수 있으며, 최대 200자리까지 입력 가능
◦
결측값을 공백문자로 처리 가능
◦
필요 없는 변수의 자료는 읽지 않을 수 있음
◦
읽는 열의 위치가 지정되므로 어떤 순서로 읽어도 무방하며, 같은 열을 반복하여 읽을 수도 있음
•
예시
DATA grade1;
INPUT name $ 11-18 class $ 20-35 classid 1-4 score 36-40 grade $ 41;
CARDS;
259067048 김철수 Statistics 80.3A
356989087 박민호 Mathematics B
704842534 이영희 30.6C
908727844 English 100 A
424573465 남궁수지 Computer Science
;
PROC PRINT DATA=grade1;
RUN;
Plain Text
복사
3) 특수 포맷으로 구분된 데이터 읽기(formatted input)
•
표준 데이터 (영문자, 한글, 숫자, -부호, 소수점 등으로만 입력)와 비표준 데이터 (그 이외 다른 특수문자, $ 등이 함께 입력)가 존재함
•
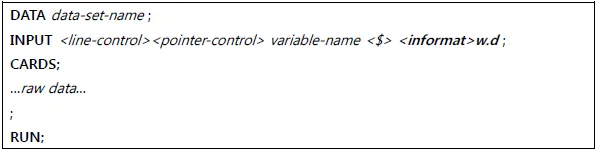
특별한 형식으로 입력된 비표준 데이터를 읽을 때에는 INPUT 명령문의 변수명 뒤에 입력 포맷 (informat, 생략 시 표준 숫자 자료로 인식)과 형식을 ‘w.d’ (w: 전체 자릿수, d: 소수점 이하 자릿수로 생략시 0으로 인식) 형태로 표기해 주어야 함
•
이 방식을 사용하는 경우 대게 아래와 같은 line-control, pointer-control 지시자가 필요함
◦
Point-control
▪
+n : 입력 포인터의 위치를 n 칸만큼 오른쪽으로 이동시켜 자료를 읽도록 지시
▪
@n : 입력 포인터의 위치를 n 번째 열로 이동시켜 자료를 읽도록 지시
◦
Line-control
▪
/ : 입력 포인터의 위치를 다음 줄의 첫 열로 이동시켜 자료를 읽도록 지시
▪
#n : 입력 포인터를 데이터의 매 n 번째 행의 첫 열로 이동시켜 자료를 읽도록 지시
•
예시
DATA dept;
INPUT name $18. +1 hired DATE7. +1 salary 5. ;
FORMAT hired DATE7.;
CARDS;
Martin, Viginia 09aug80 34800
Singleton, MaryAnn 24apr85 27900
Leighton, Maurice 16dec83 32600
Freuler, Carl 15feb88 29900
Cage, Merce 19oct82 39800
;
PROC PRINT;
TITLE 'SAS Data-Set dept';
RUN;
Plain Text
복사
2. 기본 명령어
1) SET 명령어
: 기존에 존재하는 SAS 파일을 새로운 SAS 파일로 다시 정의하거나, 2개 이상의 SAS 파일을 변수방향으로 병합할 때 사용하는 명령어
•
기존에 존재하는 SAS 파일을 새로운 SAS 파일로 다시 정의하는 경우
DATA new-data-set-name;
SET old-data-set-name;
RUN;
Plain Text
복사
•
2개 이상의 SAS 파일을 합쳐서 새로운 SAS 파일을 생성하는 경우
DATA new-data-set-name;
SET old-data-set-name1 old-data-set-name2;
RUN;
Plain Text
복사
→ SET 명령어를 이용하여 두 파일을 병합하고자 하는 경우 두 파일에 포함된 변수명은 반드시 일치해야 함.
2) MERGE 명령어
: 2개 이상의 SAS 파일을 관측치방향으로 합쳐서 하나의 새로운 파일을 만들고자 하는 경우 사용하는 명령어
DATA new-data-set-name;
MERGE old-data-set-name1 old-data-set-name2;
RUN;
Plain Text
복사
→ 두 파일에 동일한 변수명이 존재하는 경우 두 번째 파일에서 사용된 변수가 남아있게 됨.
3) KEEP 명령어
: SAS 파일에 존재하는 변수 중에서 특정변수만 포함하는 SAS 파일을 정의하고자 할 때 사용하는 명령어
•
방법1
DATA new-data-set-name;
SET old-data-set-name;
KEEP variable1 variable2 ... ;
RUN;
Plain Text
복사
•
방법2
DATA new-data-set-name (KEEP = variable1 variable2 ...);
SET old-data-set-name;
RUN;
Plain Text
복사
4) DROP 명령어
: SAS 파일에 존재하는 변수 중에서 특정 변수들을 삭제한 후 나머지 변수들만을 포함하는 SAS 파일을 정의하고자 할 때 사용하는 명령어
•
방법1
DATA new-data-set-name;
SET old-data-set-name;
DROP variable1 variable2 ... ;
RUN;
Plain Text
복사
•
방법2
DATA new-data-set-name (DROP = variable1 variable2 ...);
SET old-data-set-name;
RUN;
Plain Text
복사
5) 조건문
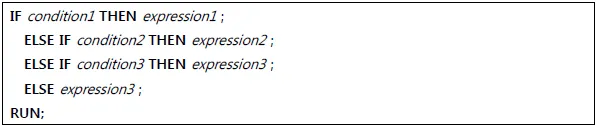
: SAS 파일에 포함되어 있는 자료에 대해 조건함수를 사용하여 새로운 변수를 생성하거나 전체 자료 중 특정 조건에 맞는 자료만을 추출하여 새로운 SAS 파일로 구성하고자 할 때 사용하는 명령어
•
Condition1을 만족하면 expression1을 실행하고, 만족하지 않는 경우 다음 구문으로 넘어가서 condition2를 순차적으로 평가함
•
예시
DATA cc ;
SET class1 ;
IF dept = '통계' THEN math1 = math+5;
ELSE math1 = math;
RUN;
Plain Text
복사